
Eine Quelle der Wahrheit. Alle Tools synchron.
Cmdbsyncer ist ein regelbasierter Synchronisations-Hub für Host- und Konfigurationsdaten. Er liest aus CMDBs wie ServiceNow, i-doit oder Netbox, aus Datenbanken und APIs, wendet deine Regeln an und schreibt das Ergebnis automatisch nach Checkmk, Netbox, Ansible und mehr.
Open Source · Self-hosted · Web-UI & CLI · entwickelt von der Kuhn & Rueß GmbH

Eine vorhersagbare Pipeline.
Cmdbsyncer führt geplante oder Ad-hoc-Sync-Jobs aus. Jeder Job liest aus einer Quelle, wendet deine Regeln an und schreibt in ein Ziel, mit vollständigem Audit-Trail und Dry-Run-Modus.
Aus Quellen lesen
Beliebige CMDBs, Datenbanken oder APIs anbinden. Pagination, Delta-Abruf und Rate-Limiting werden automatisch erledigt.
Regeln & Filter
Deklarative Regeln entscheiden, was zum Host wird, was getaggt und was verworfen wird. Voller Jinja2-Support, versionierbar.
In Ziele schreiben
Checkmk-Ordner, Netbox-Mandanten, Ansible-Inventare beschreiben, idempotent und mit Dry-Run-Vorschau.
ServiceNow und Datenqualität.
Eine weitere große CMDB als Quelle, und ein ehrlicher Blick darauf, wie gut die Daten sind, die dabei ankommen.
Direkt aus der Table-API, ohne Export.
Das ServiceNow-Plugin liest Hosts aus den CMDB-Tabellen deiner Instanz, geplant per Cron oder ad hoc über die CLI. Verbindung und Tabellen stehen am Account, den Rest machen deine Regeln.
- Beliebige Tabellen als Hosts importieren, mit Hostname-Feld, Jinja-Rewrite und Encoded Query je Account
- Netzwerkkarten, Cluster oder Datenbanken landen als Inventardaten am passenden Host, über ein Referenzfeld oder die Relationship-Tabelle
- Query- und Feldlisten halten übertragene Datenmengen klein, auch bei sehr breiten Tabellen
- Table-Explorer in der UI: Tabelle, Query und Hostname-Feld ausprobieren, bevor sie in den Account gehen
Sehen, wo die Daten auseinanderlaufen.
Das Data-Quality-Dashboard bewertet den Bestand, statt ihn nur aufzulisten: Welche Felder fehlen, welche Quelle liefert nichts mehr, welche Namen gibt es doppelt.
- KPI-Scorecards, Lifecycle-Verteilung und Auswertung je Quelle und Objekttyp
- Freshness-Badges und Erkennung stiller Quellen zeigen, welcher Import seit Tagen nichts mehr geliefert hat
- Doppelte Hostnamen, leere Pflichtfelder und Großschreibung aufspüren, samt Massen-Umbenennung auf Kleinschreibung
- Checkmk-Abgleich: Hostliste oder CSV gegen ein Checkmk prüfen, fehlende Hosts direkt anlegen, alles als CSV exportieren
Regeln entscheiden, nicht Skripte.
Deklarative Filter-, Rewrite- und Action-Regeln bestimmen, was zum Host wird, welche Labels gesetzt werden und was in welches Ziel fließt. Voller Jinja2-Support, in der UI gepflegt und versionierbar, mit Live-Vorschau und Suche.

Auch als CMDB einsetzbar.
Hosts, Services, Applikationen und Standorte sind eigene CI-Typen mit Templates, Jinja-Feldern und typisierten Beziehungen (depends_on, runs_on, member_of …), die eine vollständige Impact-Chain abbilden. Lifecycle-Stufen, Soft-Delete-Archiv, gespeicherte Suchen und ein Data-Quality-Dashboard, alles aus der UI.

Ansible direkt aus dem Syncer.
Pro Projekt eine Regel-Quelle, die als eigener Inventory-Provider dient, eine Run-Playbook-Seite mit --check --diff-Vorschau, ein Fire-Rule-Outcome, das Playbooks mit dem passenden Host-Inventar startet, und ein Manifest-basierter Playbook-Katalog mit .local-Override.

Cron-Gruppen für den Produktivbetrieb.
Sync-Jobs werden aus der UI geplant, nach Zweck gruppiert und extern über Webhook-Token pro Gruppe (SHA-256-gehasht) auslösbar. Der Resilient-Modus lässt die übrigen Tasks weiterlaufen, wenn einer fehlschlägt, abgestürzte Läufe geben ihren Lock automatisch frei, und jede Gruppe trackt ihren letzten erfolgreichen Lauf für externes Monitoring.

Gebaut für die Produktion.
Bausteine, die den Betrieb berechenbar machen.
Plugins & SDK
Wachsender Katalog an Source- und Target-Plugins, plus ein einfaches Python-SDK für alles, was noch nicht dabei ist.
Dry-Run & Audit
Jeder Job läuft auf Wunsch als Vorschau. Vollständiger Audit-Trail zeigt, was sich wann wohin geändert hat.
REST-API & MCP
Automatisiere alles per REST-API und CLI, und sprich den Syncer über den eingebauten MCP-Server direkt mit deinem KI-Assistenten.
Gespeicherte Suchen
Mächtige Suchsyntax über alle Felder, als wiederverwendbare gespeicherte Suchen, für Listen, Filter und Regeln.
Rollen & Rechte
Jede Ansicht hat ihre eigene Berechtigung, Nutzer lassen sich auf „nur lesen“ setzen, und persönliche API-Tokens ersetzen das Passwort.
Open Source & Self-hosted
Läuft komplett bei dir, auf MongoDB. Keine Cloud-Pflicht, keine Datenabflüsse. Der Open Core ist kostenlos.
Gebaut aus dem, was die Projekte brauchen.
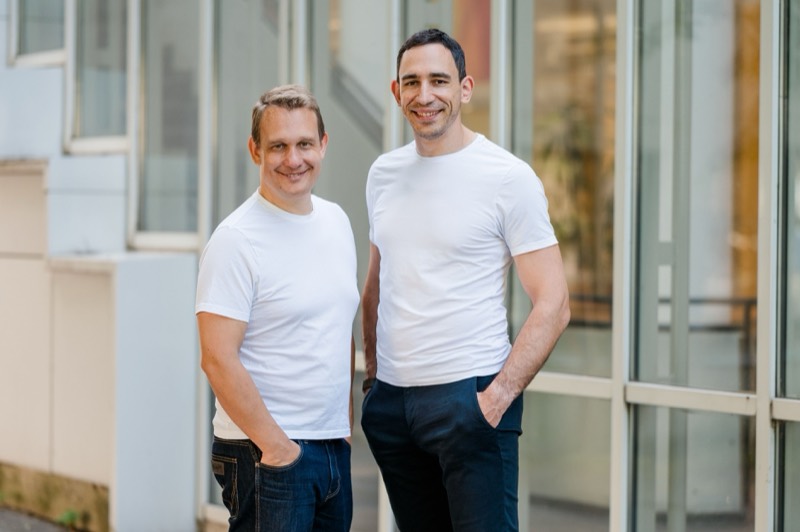
Cmdbsyncer entsteht bei der Kuhn & Rueß GmbH. Wir setzen ihn in unseren Kundenprojekten ein, und was dort gebraucht wird, bauen wir ein. Wir zwei entwickeln ihn und beantworten den Support persönlich. Wer eine Demo bucht, spricht direkt mit uns.
Bastian Kuhn & Sven Rueß
Geschäftsführer, Kuhn & Rueß GmbH
Schluss mit Spreadsheets abgleichen.
Zeit, Zustand zu synchronisieren.